Quelques éléments de compréhension sur la méthode Processor In the Loop (PIL) de Cerebrum Ingénierie.
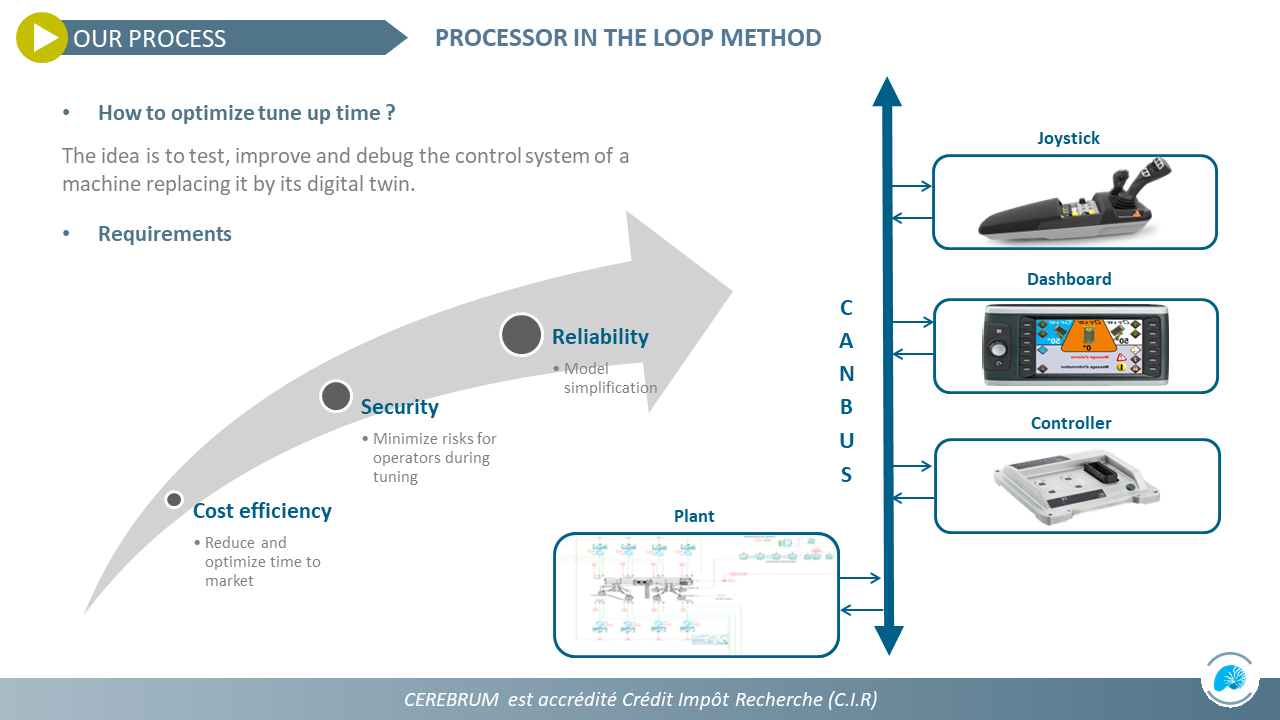
Cerebrum a développé cette démarche, que l’on peut placer entre le SIL (Software In the Loop) et le HIL (Hardware In the Loop), grâce à un outil interne. Elle permet d’implémenter le code développé au préalable directement sur l’automate ou le calculateur qui sera installé sur le système du client. Le code de l’automate communique avec le modèle virtuel : tout peut être testé et anticipé, sans limite et sans risque.
Le client gagne un temps considérable sur la mise au point des machines : 90 % du travail est fait à l’avance, il ne reste que des réglages de confort à la mise en route.
En détail
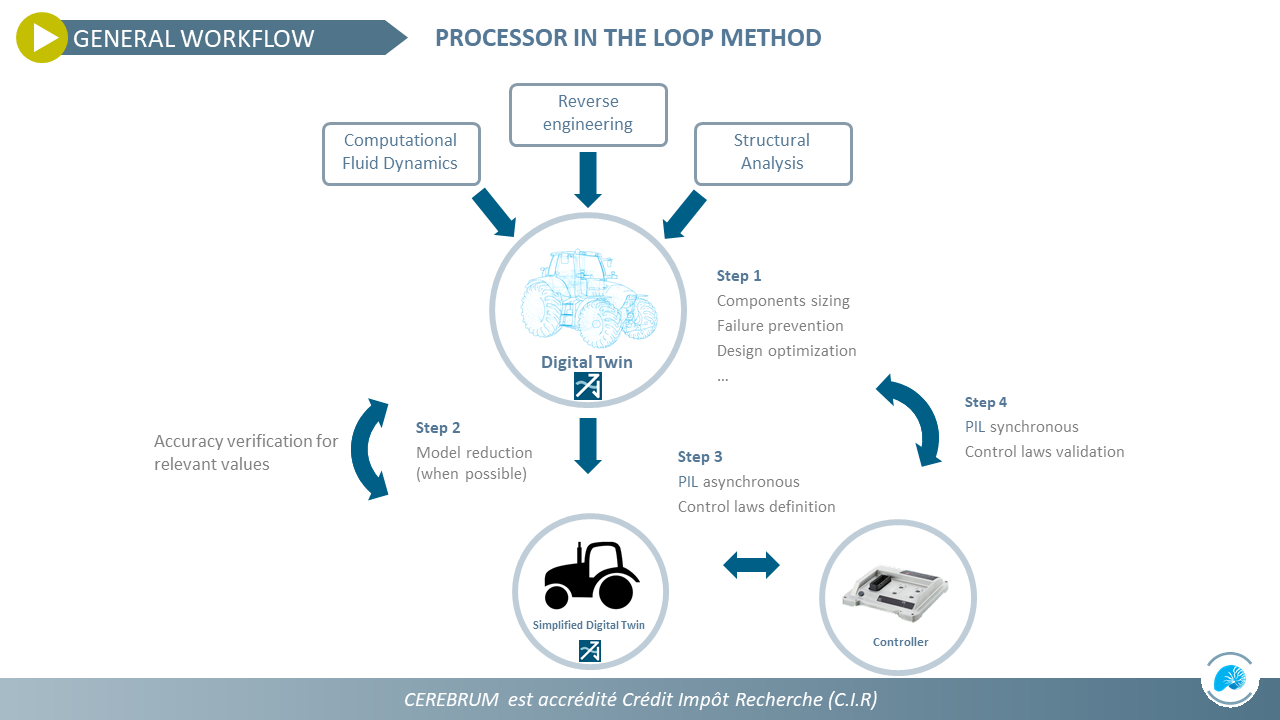
Le modèle numérique est au centre de la démarche. Il peut être complété par des données de reverse engineering, des résultats de CFD ou d’analyse de structure pour gagner en précision. Nous dimensionnons ensuite les composants, optimisons les circuits et détectons les dysfonctionnements.
Pour vérifier le contrôle-commande, nous simplifions le modèle afin d’obtenir des temps de calcul industriels : entre 3 et 7 fois le temps réel pour un PIL synchrone, temps réel pour un PIL asynchrone. En parallèle, nous développons nos lignes de code (Python, C, C++, Bodas…) ou intégrons le code du client dans l’automate.
PIL synchrone et PIL asynchrone
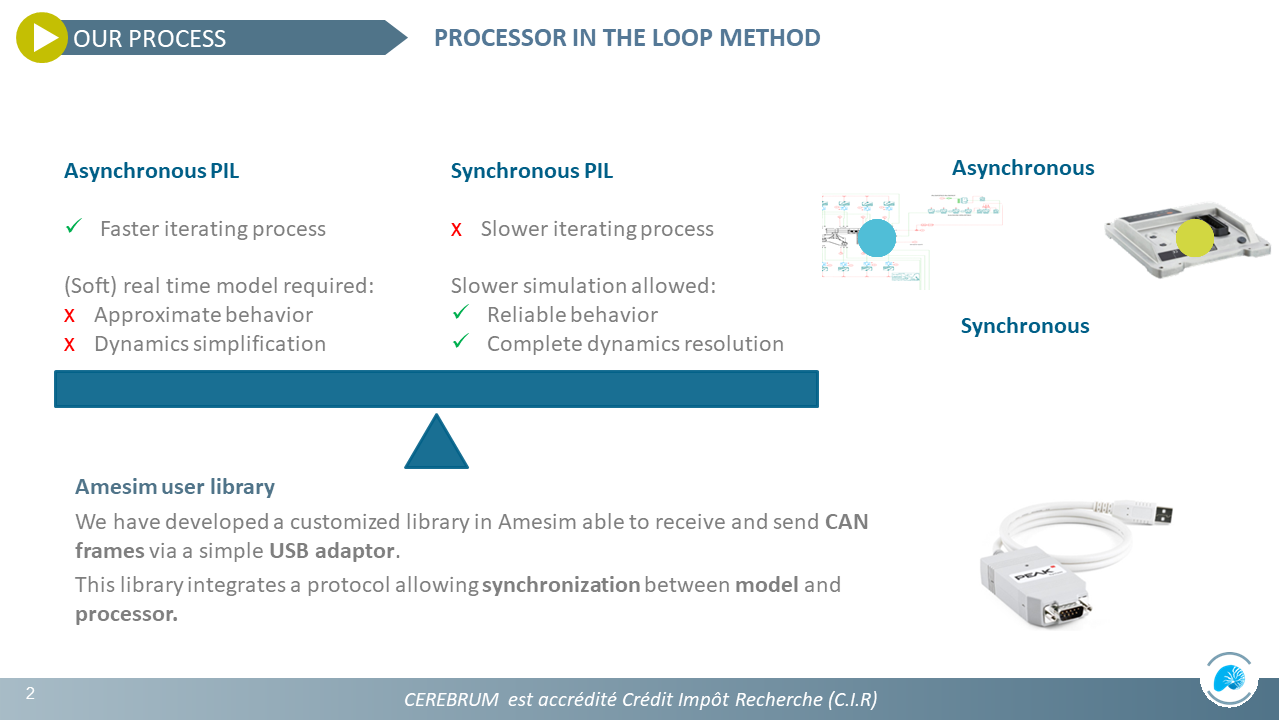
Le PIL asynchrone donne des résultats plus rapidement : le modèle est simplifié et tourne en temps réel. Le PIL synchrone est plus lent, mais reste dans des temps de calcul industriels (3 à 7 fois le temps réel) et plus précis, car le modèle conserve une meilleure dynamique.
Le choix dépend de l’application : pour gérer des zones d’intervention, le PIL asynchrone est plus adapté ; pour des résultats précis lors d’une mise en route sur une machine spéciale, le PIL synchrone est plus cohérent.